
特邀行业专家全面解读物理AI对机器人产业的推动作用,10月21日(周三)19:00,财联社VIP携手蜂网专家为您带来了物理AI主题的【风口专家会议】。


问题一:什么是物理AI?为什么不用AI大模型来驱动或训练?机器人在训练以及运行过程中如何用到物理AI?
专家:物理AI是指通过理解现实世界的物理和动力学规则,且具备实际的“身体”,比如汽车、机械臂或人形机器人之类的执行器,可对空间的感知、实际的接触和交互的AI。其概念区别于传统数字AI的纯语言模型。
物理AI的模型不能完全复用传统数字AI模型,主要原因在于物理AI涉及较多的空间感知和交互,而数字AI作为纯语言模型,仅用于处理语言、文字等,不涉及交互层面。
物理AI较传统数字AI的难度更高,可以理解为:数字AI可视为物理AI的大脑层,而要将大脑的推理及任务转换为具体的动作,则需要更高层的模型或者模块。
以ChatGPT-6 Astra等前沿研究为例,大语言模型可用于探索纯原生的数字AI在物理AI上的应用,并能够用于控制机器人,但该过程需要工程化改进与优化。
问题二:物理AI在研发过程中最重要的是否是采集数据?它需要哪些类型的数据?又是如何进行数据采集的?
专家:物理AI的模型训练与数字AI一样,需要很多具身数据。
传统数字AI模型训练的语料主要是语言和文字类的数据,普遍通过使用大量互联网视频、图像,并进行人工标记,作为大语言模型的语料去训练。而具身模型由于具有实际交互的特点,其数据的范式较语言模型更为复杂。
目前物理AI的数据结构呈金字塔型分布,主要包括真机数据、UMI数据、仿真数据、当前主流的Ego数据、以及第三视角的SO数据。在实际训练过程中,并非只使用用某一种数据,而是采用混合式的数据架构。
真机数据质量较高,但也有劣势:第一,采集效率低,一天8小时工作日,一个采集员能够采集到的有效真机数据约为一个多小时。第二,采集成本高,真实数据需要在真实的素材工厂采集,且要求有本体采集,即素材员佩戴遥操作设备,控制机器人去采集。因此,造成真机数据的价格非常昂贵,一般是十几块甚至几十块钱一条。第三,真机数据非常干净,机器人采集到的数据完全正确,缺乏完整的试错轨迹,无法提高模型通用的能力,可能不够智能。基于此,真机数据很难完成规模化的采集。
随后,数据的采集范式转变为UMI数据。其最大的好处在于实现了无本体,采集过程中不需要遥控真实的机器人,而是通过佩戴UMI的夹爪完成采集。其采集效率在同样的8小时内,有效数据采集时间约为5-6小时。与此同时,由于无本体这一特点,其采集规模也较大。尽管如此,UMI数据的采集需要佩戴末端执行器,较难完成精细动作,具有一定局限性;且其约束性较强,部署时要求采集夹爪与部署机器夹爪完全相同,包括颜色、尺寸、开合度等,实际应用中难以满足。
而后又转向第一视角的Ego数据,其优势在于采集更为简单,工作过程中仅需佩戴Ego头环,从而能够采集到第一视角数据,通过算法把双手的数据结算成手的动作数据,用于机器人训练。
经过英伟达、Figure AI等公司的验证,目前形成共识:物理AI模型遵循规模效应,这与数字AI相同。简言之,在给模型堆数据的过程中,当达到某一临界点后,模型的智能程度会形成持续上升趋势,这与大语言模型是一样的。未来,实现数据的规模化至关重要。
实现数据规模化要求实现无本体、无感的轻量化采集,且数据通过众包全民生产,而非数据工厂方式产生,从而真正实现这种数据的规模化。在此背景下,Ego数据是实现数据规模化的一个非常有效的抓手与入口。
此外,仿真数据在整个的数据结构里面也有较大占比并发挥补充作用。其优点在于成本低、效率高,且能够在仿真环境中试错,而不存在硬件损坏成本。然而仿真到现实的鸿沟仍然存在,因此仿真数据无法成为数据的主力。
基于上述主流数据结构,在模型训练中我们通常采用“预训练+后训练”的范式。未来趋势是加强预训练的训练规模,包括扩大数据规模等;逐渐减少后训练的难度及数据量,即通过少量的后训练,降低实际应用中的部署难度。
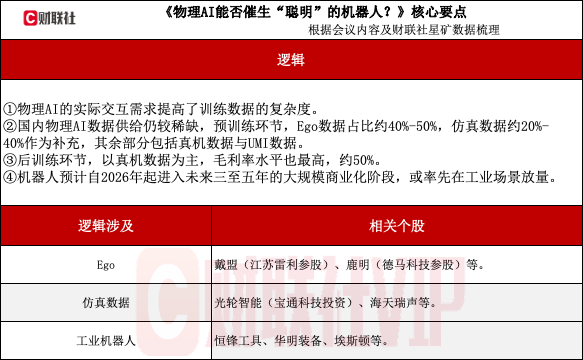
在预训练过程中,Ego数据占比约40%-50%,仿真数据约20%-40%作为补充,其余部分包括真机数据与UMI数据。后训练目的在于动作的校准与对齐,倾向精度较高的真机数据,数据量期望由目前的几百、几千条转变为几十条、甚至几条,用于微调。
问题三:目前国内机器人的数据采集方面,有哪些企业在布局?其业务量大致是怎样的?
专家:国内物理AI数据仍处于供给稀缺状态,而数据规模是制约物理AI发展的主要瓶颈之一。在此背景下,国内涌现出多类数据公司,围绕不同数据形态提供采集设备、数据产品及解决方案。
从参与主体看,国内物理AI数据公司大致可分为第三方数据公司、仿真数据公司和真机数据公司三类。
其中,第三方数据公司主要围绕Ego数据开展业务:简智提供Ego加UMI类型数据,戴盟(江苏雷利参股)开展Ego相关数据业务,鹿明(德马科技参股)、帕西尼等则可提供包括采集头环等设备及数据销售在内的Ego数据解决方案。
仿真数据公司方面,部分企业从事仿真数据业务,代表企业包括光轮智能(宝通科技投资)、海天瑞声等。
真机数据公司方面,2023年至2024年国内从事真机数据采集的公司较多,并建设了北京石景山、上海国际等多个区域采集中心。然而,当前多数真机数据采集正在收缩,市场对真机数据的需求亦呈现下降趋势。
问题四:不同数据类型的采集企业的利润情况有什么差距?
专家:不同物理AI数据类型的定价、成本结构与毛利率存在明显差异:真机数据毛利率相对较高,但高度依赖采集利用率;原生Ego数据价格和毛利均较低,并逐步呈现运营化特征;增强版Ego数据因多模态、高精度采集而显著提升价格与毛利。
具体而言,若以较高利用率为前提,尽管真机数据需求较此前下降,但由于其价格较高,单条数据可售十几元至几十元,其综合毛利率约50%。若计入均摊成本,整体经济性较难成立。
Ego数据包括原生Ego数据及增强Ego数据。其中,原生Ego数据采集效率高、难度较低,价格约为每小时几十元,扣除采集设备均摊、采集人员人工及数据处理管线等成本后,毛利率约30%,因而会逐步偏向运营型业务。增强版Ego数据在标准头戴采集基础上,进一步采集手部操作数据,尤其是融合触觉、光学动捕、IMU等的高精度多模态手部数据,价格可提升至每小时百元级,可达三四百至四五百元,毛利率有望达到50%至60%,甚至60%至70%。
问题五:机器人大脑当前控制本体的方式及其链路是怎样的?物理AI成熟后,控制运作链路是否会发生显著变化?此时硬件设备是否需要更新?
专家:当前物理AI模型架构与路线尚未完全收敛,机器人大脑的控制链路以VLA为基础,并通过引入世界模型模块补全物理规律理解与动作想象能力;同时,以大语言模型直接驱动机器人执行成为新的探索方向,但仍需其他模块配合。
传统VLA链路遵循感知、决策、规划、执行的逻辑,基于图像、视频及机器人状态等实时外部感知,结合语言信息进行编码,并通过动作头以自回归或流匹配方式生成动作序列,驱动机器关节执行。然而,其本质仍是基于模仿学习,缺乏对世界的想象力,可能生成不符合物理规律的动作。
因此,物理AI模型加入世界模型板块,帮助其理解物理规律及其变化趋势,补全物理AI模型的想象力。通过将世界模型与VLA融合,执行前由世界模型生成多个候选执行方案,VLA从中选择最优方案并转化为动作输出执行,即形成WAM思路。
当前也出现了以大语言模型直接驱动机器人或设备执行的趋势。以ChatGPT-6 Astra为例,以原生大语言模型控制机器人的链路已经打通,但仍存在一定局限性。尽管大语言模型在通用能力、泛化能力及异常自我纠错能力上具有优势,能够进行高层次的规划与理解,但由任务到动作生成这一过程仍需其他模块支持,比如结合传统运动学、动力学规则进行算法辅助。未来,若以大语言模型直接驱动机器人或设备执行的路径跑通,可能形成以DeepSeek、GPT等原生大语言模型构建物理AI大脑的新赛道。
对于底层硬件而言,则没有额外要求。原有硬件仍然可以使用,控制模型的变化并不构成对硬件的额外约束。
问题六:预计机器人的这一类的产品会有怎样的一个放量的节奏?未来哪些行业会逐步被机器人这个替代掉?人形机器人会有怎样的一个放量节奏?
专家:机器人产品预计自2026年起进入未来三至五年的大规模商业化阶段,当前主要落地场景涵盖工业、服务、特种和物流等领域。具体而言,工业场景包括产线装配、线束插拔、线边搬运等;服务场景包括商超新零售售卖、导诊前台等;特种场景包括巡检、危险场景救援及火灾等;物流场景亦为当前各方推进商业化落地的重点方向。
在未来一段时间内,预计机器人放量将率先出现在工业场景。其原因在于工业场景相对容易落地,属于半结构化环境,且任务复杂度总体可控。
因此,最先落地的将是传统机器人难以完成、且需要一定柔性和通用能力的任务。