

①软通动力到货8000张英伟达6000D显卡的消息引关注,相关推文被删除;
                                    ②记者求证消息的真实性,公司人士未正面回应,还表示“不必过于纠结”;
                                    ③根据当前市场价,该批算力卡总计金额约5.6亿元。
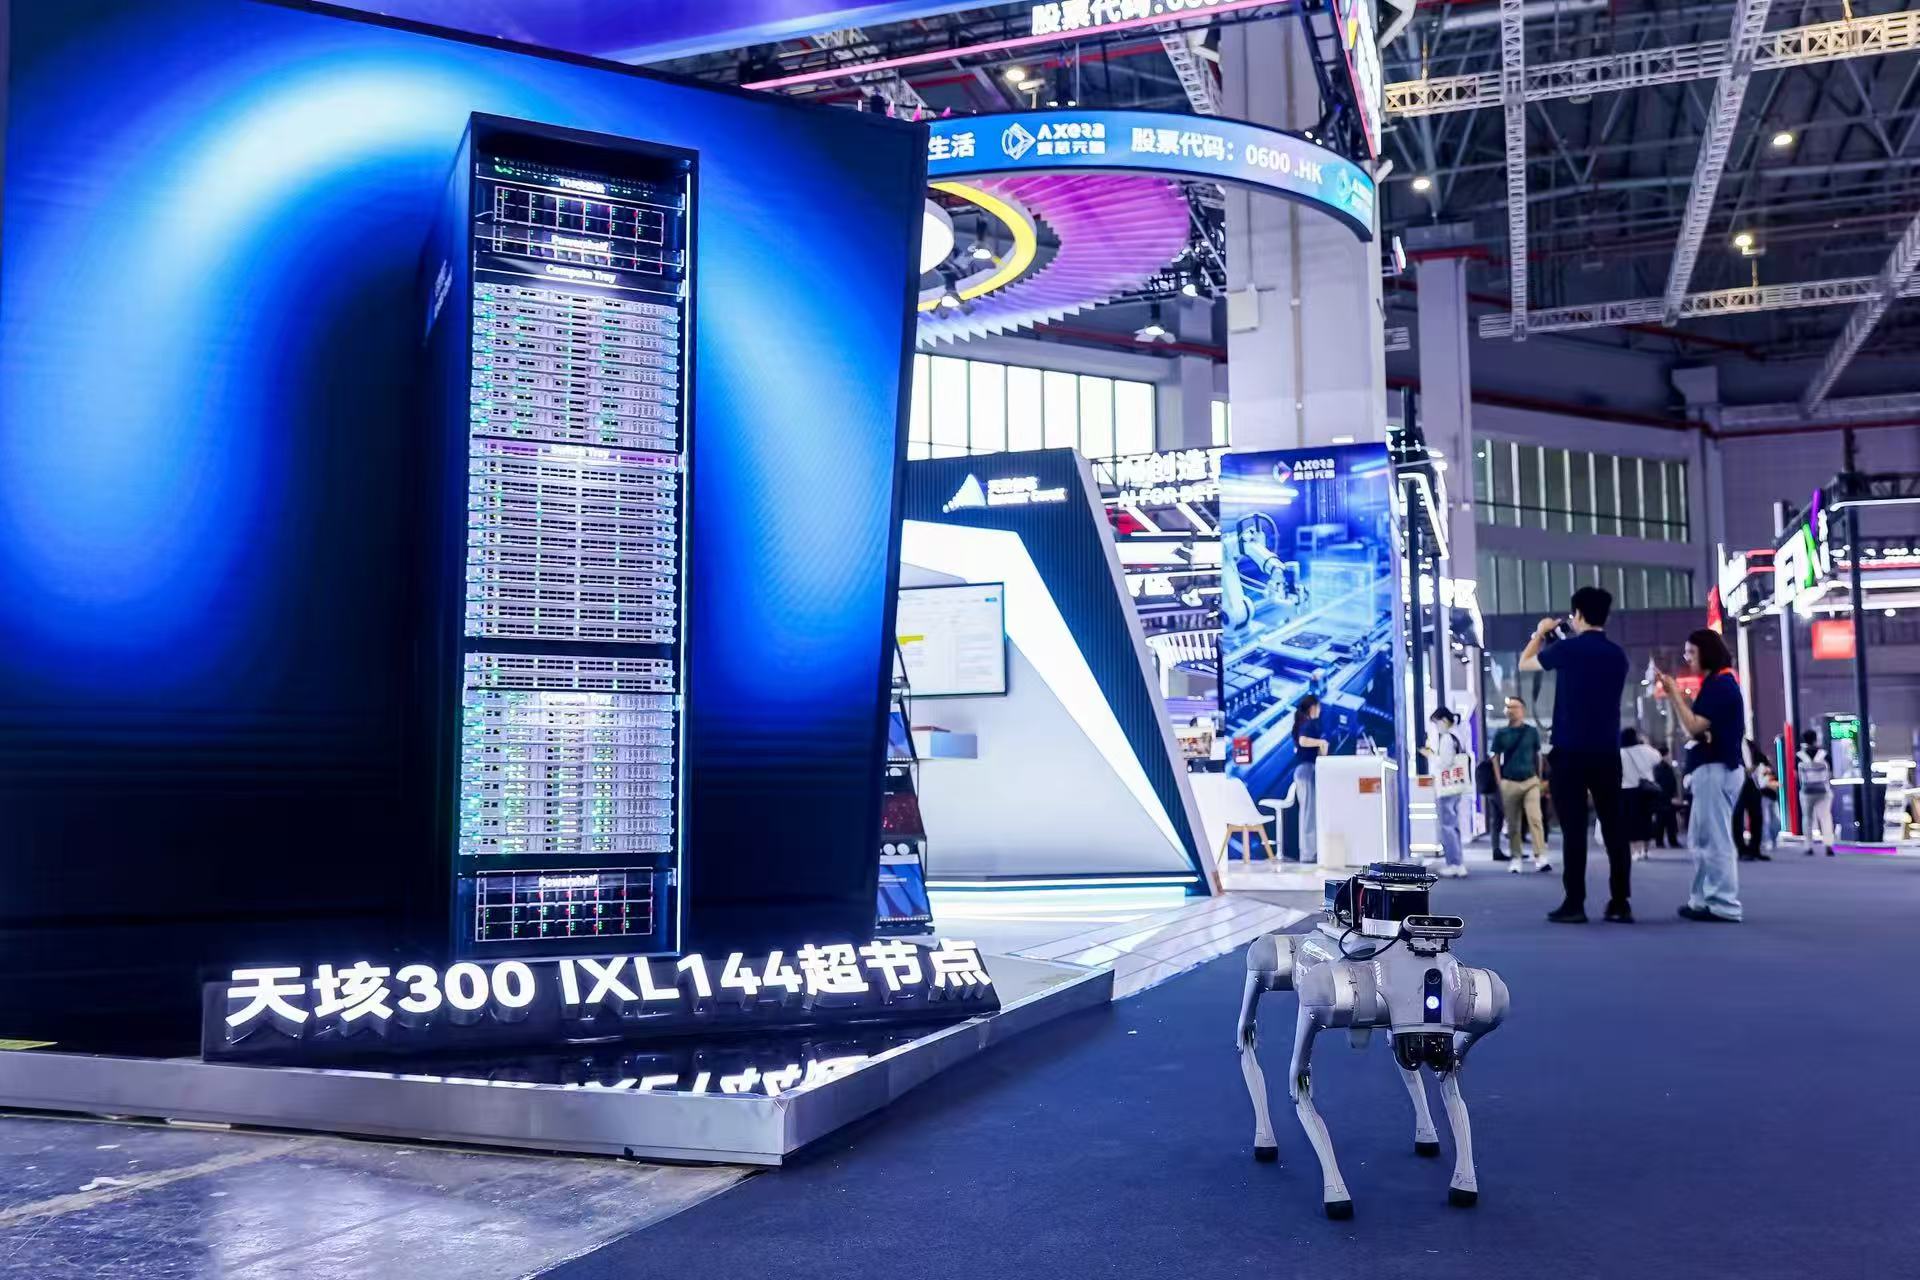
2026中国国际工业博览会上,天数智芯发布了业界最高密度单机柜GPU超节点——天垓300 IXL144,单柜集成144颗GPU与18颗CPU,其价值不止于密度,更在于系统经济效能的整体改善。
当前,超节点成为了算力市场的焦点之一。多家机构认为,超节点通过系统级重构降低通信开销,是国产算力弥补单卡差距的破局之道。华泰证券研报判断,2026年是国产超节点元年,测算2028年国产超节点市场空间有望达到3414亿元,2026年至2028年复合年增长率达194%。
当玩家纷纷涌入、产品密集发布,这一市场的胜负手正在从“造得出”转向“用得起”。东吴证券研报指出,行业关注重点已聚焦能否稳定交付、持续运行并降低单位Token成本。当单卡参数不再是唯一标尺,迁移账、机房账、运营账能否算得清,才是国产超节点规模落地的真正门槛。
算力规模跃升,超节点从“造得出”到“用得起”
中国信通院发布的《词元(Token)经济发展研究报告(2026年)》预计,2026年推理算力占AI算力总负载的比重将达到70.5%,AI算力需求正由模型训练进一步向推理和智能体运行转移。与此同时,中国AIDC市场规模预计突破4200亿元人民币,占全球总规模的比重接近35%,用于模型推理的算力消耗占比预计达到58%。这意味着算力需求的增长曲线已不再依赖训练侧的阶段性投入,而是由实际业务运行所驱动的持续性消耗。
需求结构的转变,改变了用户评估算力的标准。过去看单卡峰值算力,现在看单位投入能产出多少有效Token。信通院报告指出,AIDC的单兆瓦价值是传统IDC的三到五倍,交付形态已从“出租机柜”转向“出租算力”。这一模式重构的背后,是客户对算力投入产出比的重新审视。
与此同时,国产GPU的市场地位正在发生逆转。开源证券研报指出,当前国产GPU产业正跨越从芯片可用到规模可用的核心门槛,下一轮行业分化的核心判断指标不再是单卡控制参数,而是软件成熟度、集群有效算力、供应链持续性和客户服务。
在这一背景下,超节点从技术验证走向规模采购。2026年被行业定义为“国产超节点元年”,天数智芯、华为等厂商集中推出超节点整机柜产品。超节点整机柜的设计需解决高密度GPU协同工作的挑战,交付单元从单台白盒服务器跃迁为整机柜乃至Pod级系统交付。天数智芯的天垓300 IXL144,正是在这一竞争格局中推出的首个系统化方案。天数智芯副总裁邹翾透露,“天垓300 IXL144只是一个开始,是天数智芯整套系统化超节点方案中率先推出的第一个;面向不同算力规模、不同机房条件的完整产品布局已经形成,后续将在合适场合逐一呈现,系统展示我们对超节点的整体思考与技术布局。”
目前,天垓系列已实现万卡级规模部署,天数智芯由此具备系统级交付与运维经验,从今年1月公布四代架构路线图、7月WAIC发布天垓300,到此次展示IXL144方案,旗舰GPU能力正从单芯片延伸至整机柜,并在真实机房中持续迭代。
超节点背后的经济账
用户采购算力,至少需要算三笔账:一是迁移账,已有模型和代码是否要推倒重写;二是机房账,是否要为整机柜改造供电、承重、散热乃至新建机房;三是运营账,每百万有效Token成本能否下降,算力能否按需扩展而不形成闲置。这三笔账合在一起,衡量的正是系统经济效能,即在真实部署条件下,单位投入能够持续产出多少有效算力。
机房账尤其关键。行业分析显示,老机房改造面临承重、配电、散热三道硬约束:楼板承重600至1000 kg/m²的办公楼机房,放不下1.5吨级的满配液冷柜;市电扩容涉及电网增容审批,周期以年计。主流整机柜超节点多采用专用形态,配套专属液冷与供电,往往要求专门机房,即“先建房、再上柜”,改造投入大、周期长。
而天垓300 IXL144采用贴近常规机柜标准的单机柜形态,在供配电、承重与散热条件匹配时即可进入现有机房;结合灵活组网拓扑,可一次规划、分步扩展,避免一次性过度投入。对客户而言,这意味着机房账更可控,不必为超节点重建一套基础设施。
迁移账同样重要。天数智芯的自主通用GPU架构与自研软件栈兼容CUDA生态,支持客户复用已有模型、主流框架及开发经验。作为通用GPU,同一底座既承载大模型训练与推理,也支撑金融估值、科学智能等任务,客户不用为不同业务重复建设算力底座。
此外,资源利用率也是考量重点。IXL144通过高带宽整柜P2P互联、100ns级单跳时延、原生Load/Store与跨节点显存直访,将144颗GPU组成统一内存语义的高带宽域;约10.1TB显存为模型权重、MoE专家和长上下文KV Cache留出空间。模型所需并行资源更多在单柜内协同,高频All-to-All交互留在柜内,减少跨柜等待。其互联参考设计在特定MoE All-to-All场景实现有效带宽提升15%,资源利用率与单柜业务承载随之改善。
在交付与服务环节,天数智芯的本地化团队提供必要的部署、运维与扩容支持,为大型算力投入提供长期保障;更核心的是系统经济效能的提升,通过计算、互联与调度的协同,让同等投入转化为更多有效算力。据测算,每百万有效Token的成本较国际主流方案可降低40%。
通过PD分离盘活存量算力
智能体应用的规模化落地,正推动长上下文、多轮交互等推理负载持续增长,也对算力资源的配置方式提出了新的要求。对于已建设GPU推理集群的客户而言,扩容不仅要考虑现有设备的利用效率,也要权衡新增投入的性价比。PD分离把输入处理与输出生成独立部署,让用户能够按不同的设备特点分配任务,针对实际瓶颈补充算力,在复用现有资源的前提下扩大服务承载。
天数智芯的PD分离方案,提供了一个存量协同的样本。比如,某企业用户已有H200推理服务,需要扩展新增预填充处理能力。长文档与多轮Agent增加输入计算负担,P、D负载增长不同步,若继续购买同型设备,可能为瓶颈部分过度投入。
天数智芯的方案不是推倒重来,而是增配2台天垓上一代产品承接预填充计算,让1台H200集中处理解码,复用既有GPU能力。P、D资源池独立扩缩,按输入负载扩展P端,按业务瓶颈选择配比。这一异构协同方案通过RDMA传输KV,实现P/D量化精度对齐,使用SGLang运行DeepSeek-R1 671B。
在最终测试中,2台天垓上一代产品叠加1台H200,相较2台H200的方案,每分钟请求数提升58.5%,输出Token吞吐达3831 Token/秒,平均首字响应1.79秒,平均Token间隔35.69毫秒。国产GPU以增量方式进入已有系统,扩大业务承载,同时保护用户既有投资。
天垓上一代产品同构方案则面向国产推理服务建设。P、D均由该产品承载,统一软件栈Dynamo/vLLM Router,支持DP+EP运行DeepSeek-V4-Flash-0731,启用DSpARK;同一16卡配置结合缓存复用与并发调优,面向长短输入混合场景。测试显示,16并发混合上下文平均输入22,299、输出539 Token,缓存命中79.52%,总Token吞吐达161.43万/分钟;同配置8→16并发总Token吞吐提升66.1%,平均首字响应1.818秒,平均每Token耗时21.64毫秒。这为国产GPU完整承载推理服务提供了可验证样本。
把超节点与PD分离结合来看,天数智芯的思路更清晰:前者解决整柜密度、机房兼容和互联效率,后者解决存量协同、按瓶颈扩容和推理服务国产化。两者共同指向一个目标——降低客户采用门槛,让客户以熟悉的真实业务负载评估性能,验证结果更贴近生产,也更有把握推进后续验证、采购与扩容。
据悉,天数智芯已服务30多个行业的380多家商业化客户,落地部署超过1000个项目。在生态方面,开发者可在工博会现场体验Iluvatar SkillHub,通过Agent调用Skills,基于天数智算软件栈完成模型适配、精度调优等工作。近期,天数智算软件栈还将迎来版本更新,进一步构建面向Agent协同的智能开发套件,将AI引入模型适配、部署与性能优化等环节,推动开发由人工操作为主向人机协同演进。
正如天数智芯副总裁邹翾所言,超节点不是单一产品,而是一项系统工程,最终比拼的是系统经济效能。国产算力竞争进入下半场,单芯参数只是起点,谁能让算力投入更贴近现有机房、更兼容已有资产、更匹配真实业务负载,谁就能更快把超节点的落地,转化为可规模复制的商业价值。
