
×
①具身智能数据采集集中式训练场模式加速退潮,无本体采集技术推动众包升温,觅蜂科技推出“觅蜂派”平台,内测一月注册2万人。
②行业仍面临数据量级缺口、有效率偏低、模态局限与隐私合规等深层瓶颈,众包模式的实际价值仍有待市场验证。
《科创板日报》9月24日讯(记者 李佳怡)具身智能数据采集进入众包时代,真实场景成为新战场。
近两年,具身智能行业围绕数据采集展开密集探索,集中式训练场一度被视为解决数据饥渴的主流路径。
然而,当下这一模式正加速退潮。据不完全统计,截至2026年6月底,全国已建成启用超过70家训练场,另有46家处于在建或规划阶段,但结构性缺陷已随规模扩张加速暴露。
与此同时,无本体采集技术的成熟让数据采集不再依赖机器人本体,众包模式迅速升温。9月23日,智元机器人孵化的觅蜂科技发布物理AI数据众包平台“觅蜂派”,内测一个月注册用户达2万人。
需要注意的是,数据缺口之外,有效数据率不足、模态局限与隐私合规等深层瓶颈依然待解。
▎集中式退潮,众包上线:从“建场馆”到“走进正在干活的地方”
近两年,具身智能行业围绕数据采集方案展开广泛探索,多家企业纷纷投建具身智能训练场。据不完全统计,截至2026年6月底,全国已建成启用超过70家训练场,另有46家处于在建或规划阶段。
此前,遥操真机是较为主流的采集方式,多采用政企共建模式:地方提供场地、资金、政策及产业资源,企业负责机器人、技术与运营团队。在几千平方米的厂房内,家庭、工厂、商超等场景被一比一还原为样板间。操作员通过手柄或VR设备远程操控机器人,在样板间内反复执行抓取、分拣、搬运等任务,逐帧记录视觉、关节角度与力控反馈等数据,试图通过集中式、规模化采集填补数据缺口。
然而,这条路径正在快速失效。集中式采集虽在短期内解决了具身数据“从无到有”的问题,但其结构性缺陷也随着规模扩张加速暴露。
8月,坐落于北京首钢园的北京首家人形机器人数据训练中心,运行不足18个月后悄然停运,原运营方睿尔曼智能撤出全部自有设备与机器人,原址以“4D高斯光场+世界模型”的新技术路线重新亮相。
集中式场馆环境高度受控,光线、地面、物品位置几乎不变,真实世界往往伴随着光线变化、物品遮挡、位置偏移等随机事件。此外,遥操员全天在岗,有效产出往往只有两三个小时真值数据,再叠加设备折旧、场地租金、复位和标注成本,重资产模式下单条有效数据成本难降。
更深层的矛盾在于,地方要的是“建起来”,模型厂商要的是“用得上”。地方建数采中心的逻辑往往是基建投资和招商落地,建了多少平方米、部署了多少台机器人、拉动了多少产能等;而模型厂商需要的是真实有效数据,失败恢复、力觉反馈、长尾罕见场景等。
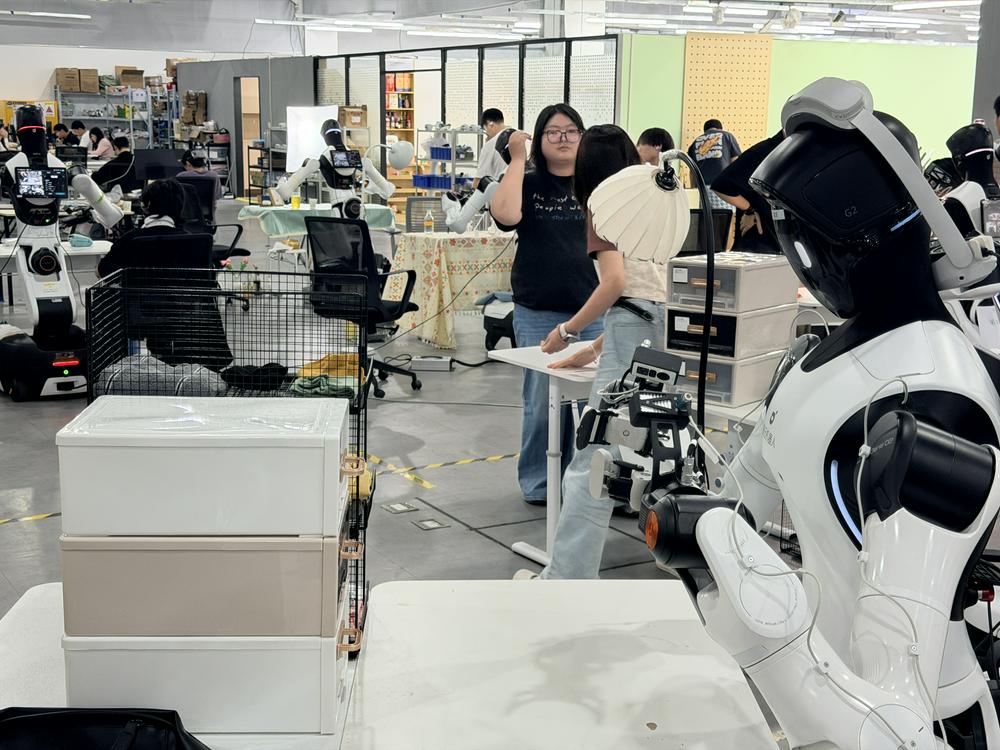
而当下,无本体采集技术的成熟,让数据采集不再依赖机器人本体——人戴上头戴式设备,在真实场景中正常完成操作,数据即可被记录。这种“边干活边采集”的模式,迅速点燃了兼职市场。
9月9日,人力资源和社会保障部发布第八批新职业,包括11个新职业和23个新工种,新工种中新增“具身智能机器人应用技术员”职业,下设“具身智能机器人数据采集员”“具身智能机器人训练师”2个工种。
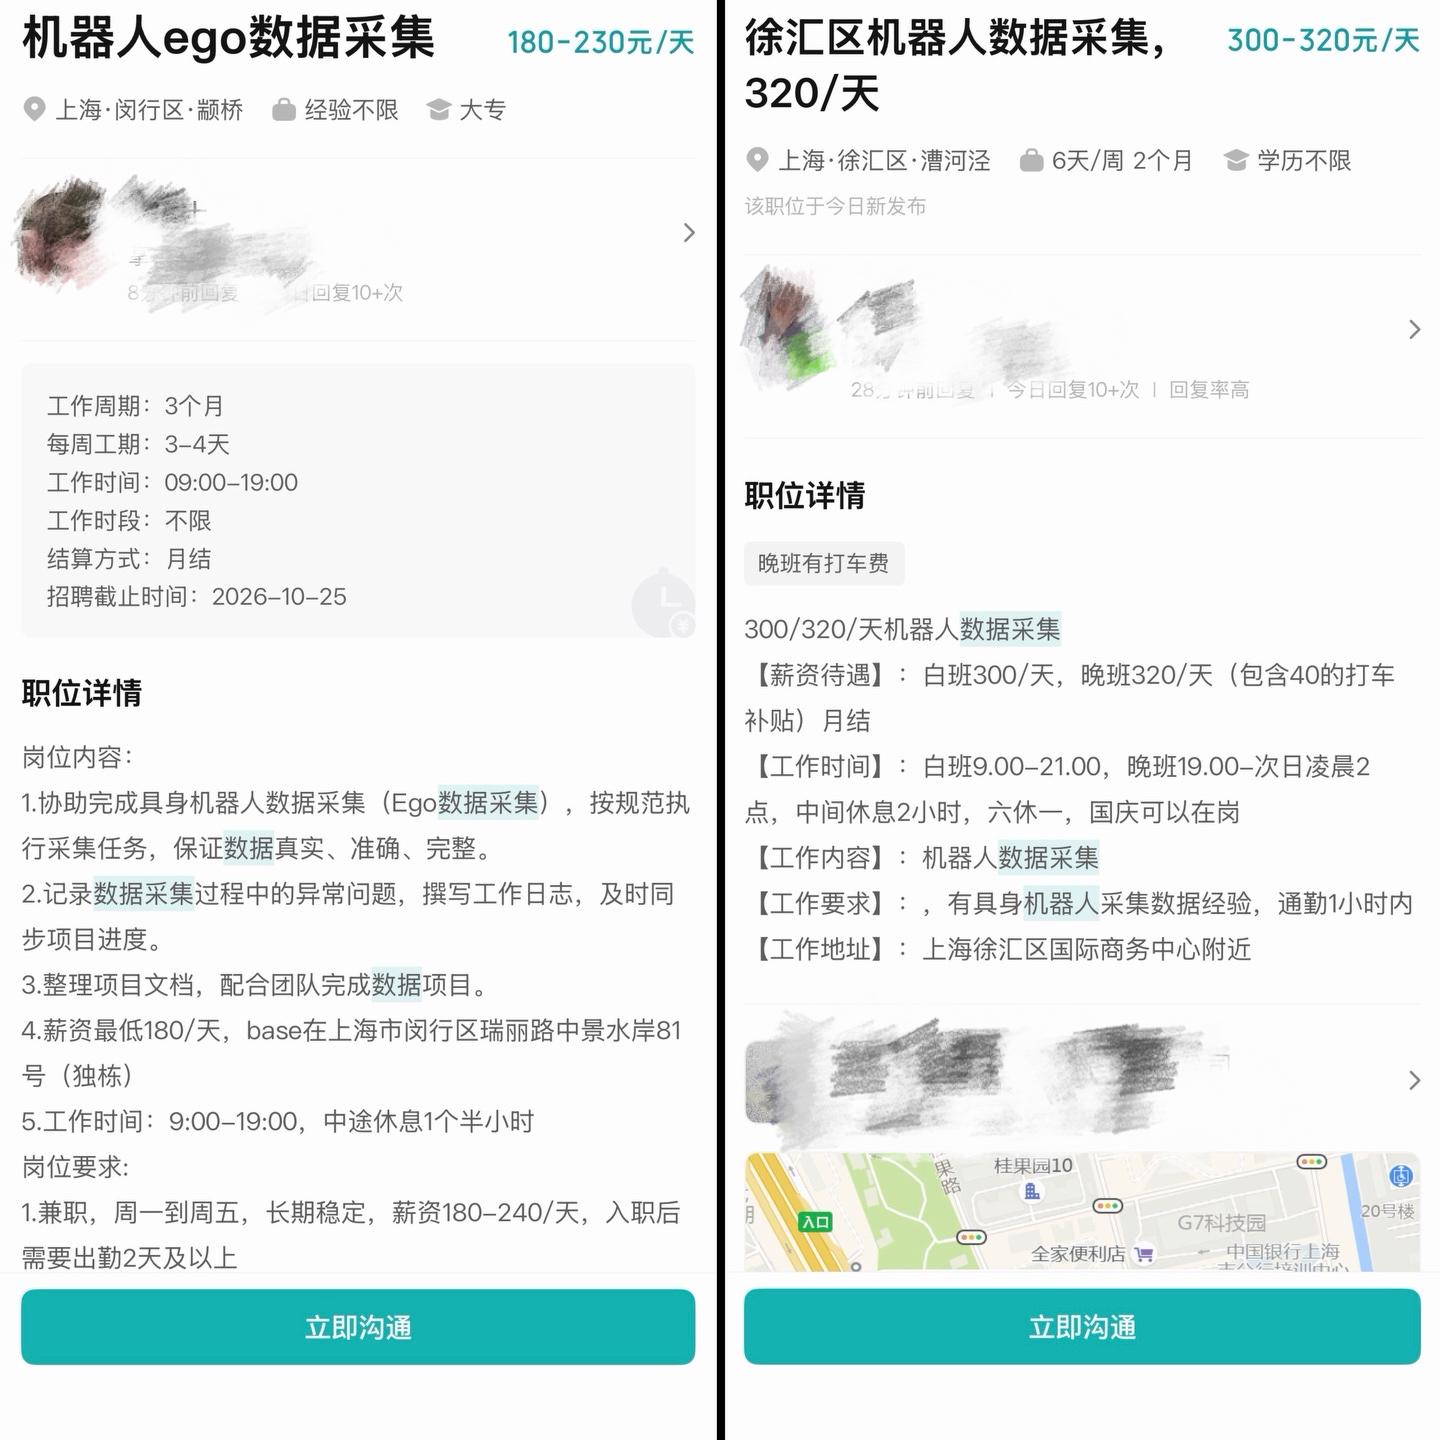
《科创板日报》记者在招聘软件上也注意到,大量数据采集相关兼职岗位正在挂出,日薪150至300元不等,招聘信息也明确鼓励宝妈、在校学生、新手等投递简历。
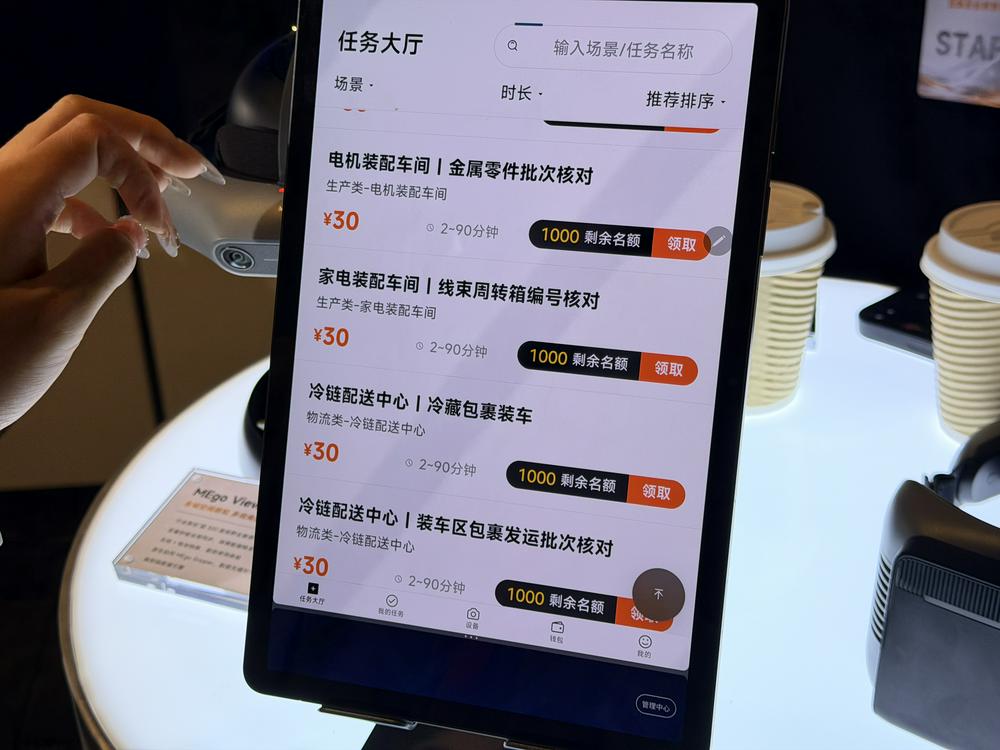
与此同时,觅蜂科技物理AI数据众包平台“觅蜂派”的发布也将这一兼职浪潮推向了平台化阶段。用户下载觅蜂派App,可申领或租用数据采集设备,领取生产类、生活服务类、餐饮类、办公类等场景任务,完成任务后按有效时长获得收益。
《科创板日报》记者在“觅蜂派”APP上看到,平台上的任务如冷链配送中心的冷藏包裹装车等任务,采集时间通常在2至90分钟,预计收益一小时0.67元至30元。
据觅蜂披露,觅蜂派覆盖22大类场景、5000多个任务和50000多个真实环境,内测一个月以来,注册用户数达2万人、采集提交总量1.3万份。觅蜂科技工作人员也记者透露,目前已回收数据中有效数据占比可达80%。
觅蜂科技董事长兼CEO姚卯青在接受《科创板日报》等媒体采访时表示,行业当前的重点已不再是简单堆量,而是向细分赛道和专业技能纵深挖掘。“比如过去大家扎堆做家庭场景、叠衣服,这类数据已经泛滥了。现在更需要的是更专业的技能,如修水管、修车、理发、美甲,正等待被一个个点亮、解锁。”
姚卯青强调,当前需求缺口相对于市场供给而言仍然很大,且这一缺口不仅体现在数量上,更体现在场景的细分程度和专业深度上。相比过去粗放式阶段,行业已经进入新阶段,必须通过众包方式更快触达更多行业和场景。
▎数据缺口之外,具身数采还有哪些瓶颈?
中国信通院《具身智能训练场研究报告(2026年)》指出,具身基础模型要迎来“ChatGPT”时刻至少需要千万小时级真实数据,而当前全球可用的高质量真实数据仅为数十万至百万小时级,供需之间存在量级差距。
然而,数据缺口只是第一层。在它之下,有效数据率、模态局限、合规风险等等问题,也正在构成具身数采更深层的结构性困局。
有效数据率是横亘在行业面前的第二道门槛,行业众包数据实际可用率普遍较低,低质量“脏数据”还会造成模型训练错误,反而拖累研发。据此前媒体报道,有公司批量买回数据,花费大量时间和人力清洗,最后能够喂进模型的有效数据率只有10%。
觅蜂科技董事长兼CEO姚卯青则向《科创板日报》记者表示,当前觅蜂派的结算环节以自动化质检为主,切掉手部不在画面、休息、动作不规范等无效片段,70%-80%的数据可保留,再根据质量高低匹配不同模型训练需求。
“我们不会把数据去做非黑即白的分化,数据质量可以分很多层,根据不同下游模型类型或者不同模型的训练阶段,可以去利用不同质量等级的一些数据。”姚卯青表示,“我们会给它贴上一些质量标签,把他们尽可能保留下来。”
与此同时,当前数采行业也存在模态局限问题。以视觉为主的第一视角数据采集,本质上仍是在二维平面上记录画面变化。它能告诉模型看到了什么,却难以完整还原动作背后的物理逻辑,施力大小、接触状态、深度关系等等,是纯视觉方案难以覆盖的信息盲区。
姚卯青认为,当前数采领域对空间精度已有较高共识。无论人手操作还是UMI设备采集,录制的原始素材都是2D视频,关键在于如何从中反解出6D六维高精度空间信息,目前行业已能达到五毫米、三毫米的空间精度。此外,对作业过程进行语义动作层面的描述性标签标注,也正在以自动化方式为主推进。
另一方面,在数据采集过程中如何做到隐私合规也是当前业内讨论焦点,众包采集进入真实家庭和商业场所,必定涉及第三方个人隐私和授权。2026 年 7 月 15 日,网信办等五部门联合发布的《人工智能拟人化互动服务管理暂行办法》正式施行,AI 训练数据的管理第一次有了专门规章。
对此,觅蜂众包总经理张智富也向《科创板日报》等媒体介绍了“五层防护网”:众包人员注册时需签署个人信息授权协议、领取设备时做端上脱敏、云端自动脱敏和预防机制、合规质检(涉及涉性、涉政、涉敏、涉恐)、与国家相关主管部门协同。
需要注意的是,这套机制虽然覆盖了从注册、采集、上传到质检的全链路,但众包模式本身决定了防护边界会随规模持续扩张。参与人数越多、进入的场景越分散,合规管理的边际成本就越高。觅蜂这套机制能否在规模扩张中持续有效运转,仍有待长期观察。
从集中式场馆到社会化众包,具身数据采集正在经历一轮路径切换。觅蜂派将这一模式推向平台化,但数据采集的终点从来不是上传量,而是模型能力的实际提升。
姚卯青预计觅蜂科技今年底产能达到千万小时级,2027年再上一个数量级。产能爬坡可以靠投入拉动,但80%的有效数据率能否被下游客户验证,“采回来但用不上”的数据能否比过去更少,将决定这条路径未来能走多远。